


Anthropic vient de lancer Claude Opus 5.5 avec une performance proche de celle de Fable 5.1 et une consommation bien plus basse. L’entreprise mise sur un modèle plus rapide, moins cher et mieux armé pour les longues tâches.
Avec Claude Opus 5.5, Anthropic annonce un gain net face à Opus 5. Ce nouveau modèle traite notamment les migrations massives, les audits logiciels et les longues tâches automatisées. Et non, à en croire l’entreprise, ce n’est pas juste de la théorie. Puisqu’un test porte sur une base de 200 000 lignes de code. Claude Opus 5.5 l’a auditée et corrigée en moins de trois heures. Or Opus 5 avait nécessité plus de 20 heures et 2,5 fois plus de tokens.
Claude Opus 5.5 mise sur la performance
Le test sur la base de 200 000 lignes de code n’est pas le seul qui prouve la performance de Claude Opus 5.5. Un autre test porte sur HAProxy, un logiciel majeur de répartition du trafic web.
Opus 5.5 a réalisé sa migration de C vers Rust en 9,5 heures. Fable 5.1 avait besoin de 12 heures. Le résultat devient encore plus intéressant sur le plan financier En effet, Anthropic affirme que son nouveau modèle coûte 51 % moins cher sur cette tâche.
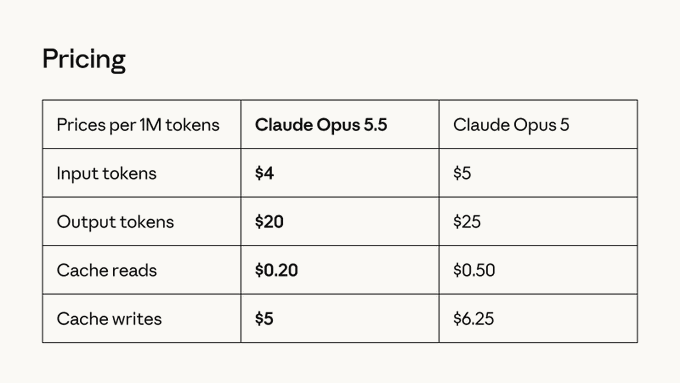
Le tarif API baisse aussi. Le million de tokens d’entrée passe à 4 dollars. La sortie coûte 20 dollars par million de tokens. Les lectures du cache tombent à 0,20 dollar. Anthropic annonce aussi une génération plus rapide de 30 % face à Opus 5. Un mode rapide peut même multiplier la vitesse par 2,5.
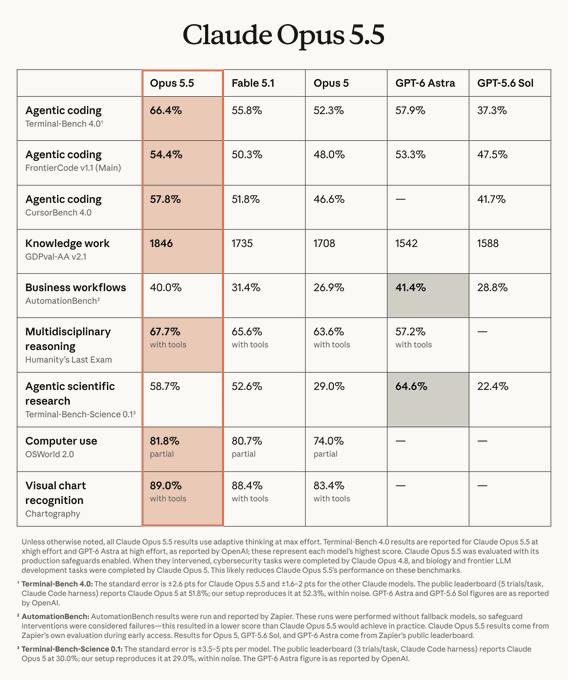
Par ailleurs, les benchmarks placent Opus 5.5 devant Fable 5.1 sur plusieurs tests. Sur Terminal-Bench 4.0, il atteint 66,4 % contre 55,8 %. Sur FrontierCode, l’écart atteint aussi 4,1 points. Opus 5.5 obtient 54,4 %, contre 50,3 % pour Fable 5.1.
Un modèle pensé pour les entreprises
Les entreprises observent surtout la consommation des modèles IA. Chaque gain sur les ressources peut modifier les projets envisagés. Les tarifs plus bas annoncés par Anthropic profitent sans doute aux sociétés.
Le rapport coût-performance devient plus intéressant que le score brut. Anthropic affirme qu’Opus 5.5 peut égaler GPT-6 Astra avec environ 40 % du coût sur Terminal-Bench. Sur CursorBench, le modèle dépasse aussi GPT-5.6 Sol de 11 points. Anthropic revendique alors environ un tiers du coût par tâche.
Pour les développeurs, cette différence peut peser lourd. Un agent qui travaille durant plusieurs heures peut générer une facture bien supérieure à celle d’une simple requête. Cependant, la puissance garde ses limites.
Les résultats publiés par Anthropic viennent de tests internes et de partenaires externes. C’est vrai que les benchmarks donnent une indication utile. Mais ils ne remplacent pas les essais menés avec des données propres à chaque organisation.
Un modèle plus puissant impose aussi plus de garde-fous
Sur ce point, tout le monde est d’accord. Anthropic ne présente pas Opus 5.5 comme une simple machine performante pour le codage. Le modèle affiche aussi de solides résultats en recherche, analyse financière et travail documentaire. Sur GDPval-AA v2.1, il obtient 1 846 points Elo. Fable 5.1 atteint 1 735 points sur cette évaluation professionnelle.
La communication progresse aussi. Anthropic affirme que le modèle écrit de façon plus claire et place les informations importantes plus tôt. Ce détail semble secondaire. Il devient pourtant utile lors des longues sessions avec un agent.
Anthropic renforce surtout les protections liées aux capacités du modèle. Opus 5.5 bénéficie de garde-fous similaires à Fable 5.1 pour la cybersécurité et la biologie. Le modèle réduit aussi fortement certaines tentatives de contournement. L’entreprise mesure environ 85 % de tentatives en moins face à Opus 5.
Cette progression ne supprime toutefois pas tous les risques. Anthropic reconnaît elle-même les limites des évaluations actuelles. Le vrai changement se situe donc ailleurs. Claude Opus 5.5 associe la performance d’un modèle très haut de gamme avec une facture plus légère.
- Partager l'article :


