


L’ingénierie des données connaît une mutation profonde portée par le cloud, l’essor de dbt et la multiplication des produits de données. Dans ce contexte, Dagster gagne du terrain face à Apache Airflow en proposant une orchestration pensée dès l’origine autour des actifs de données. Cette dynamique ne signifie pas qu’Airflow disparaît : sa version 3.x a elle aussi modernisé en profondeur son modèle de planification et introduit des fonctions orientées assets.
Airflow conserve un rôle clé grâce à sa maturité, à son écosystème et à l’ampleur de sa communauté. Mais les équipes qui conçoivent de nouvelles plateformes data recherchent de plus en plus une orchestration directement reliée à la fraîcheur, à la qualité et au lineage des données produites. L’intérêt de Dagster tient précisément à cette approche asset-centric, tandis qu’Airflow évolue désormais lui aussi dans cette direction.

Airflow et Dagster : deux visions de l’orchestration
Né chez Airbnb, Apache Airflow s’est imposé comme le standard historique de l’orchestration. Son modèle reste fortement structuré autour de DAGs et de tâches, avec un vaste écosystème d’opérateurs et de providers couvrant une très large partie des services cloud. Airflow 3.x a toutefois enrichi cette architecture avec des Assets et une planification capable de réagir à l’état de certaines données, ce qui réduit l’écart avec les orchestrateurs plus récents.
De son côté, Dagster adopte un paradigme fondé sur les actifs logiciels, ou Software-Defined Assets. Le développeur y déclare directement la donnée finale à produire, telle qu’une table Snowflake ou un modèle dbt. L’orchestrateur déduit ensuite principalement le graphe d’exécution à partir des dépendances logiques entre ces objets. Cette architecture privilégie ainsi une logique de résultat axée sur la valeur et la qualité des données.
La différence majeure tient surtout à leur point de départ architectural. Dagster a été conçu autour des Software-Defined Assets : tables, fichiers, modèles dbt ou autres objets de données deviennent des éléments de premier rang du système. Airflow conserve un héritage plus centré sur les DAGs et les tâches, même si ses versions 3.x permettent désormais de modéliser et de planifier des Assets. Dagster garde ainsi une approche plus profondément asset-centric, là où Airflow combine désormais les deux modèles.
Le passage des tâches aux assets
Le modèle historique d’Airflow reste centré sur l’exécution des tâches : une tâche réussie indique d’abord que son traitement s’est terminé sans erreur. Cela ne garantit pas automatiquement la qualité métier de la donnée produite si aucun contrôle explicite n’a été ajouté. Airflow 3.x permet toutefois de représenter des Assets et d’en suivre l’état, tandis que les validations de qualité peuvent être intégrées via des tâches, des opérateurs ou des outils spécialisés.
À l’inverse, Dagster privilégie un modèle orienté sur la valeur réelle des actifs numériques. L’exécution peut s’adapter à l’état de la donnée en contrôlant sa fraîcheur et sa qualité finale. Les dépendances entre tables brutes et indicateurs métiers sont déclarées de façon explicite. Cette structure permet un suivi précis de chaque objet produit au sein du catalogue.
Cette vision par actifs facilite une gestion fine des partitions de données. Lorsque les dépendances, les partitions et les règles d’automatisation sont correctement déclarées, Dagster peut cibler uniquement les partitions ou les actifs qui doivent être rematérialisés plutôt que de relancer un pipeline entier. Ce comportement dépend toutefois de la modélisation du projet : il ne s’applique pas automatiquement à tous les workflows.

Un déclenchement intelligent piloté par l’état des données
Apache Airflow s’est historiquement développé autour de la planification temporelle, notamment via des expressions Cron. Ce modèle reste très utilisé, mais Airflow 3.x ne se limite plus aux horaires fixes : il prend aussi en charge l’asset-aware scheduling et des mécanismes event-driven capables de déclencher des traitements lorsqu’un état ou un événement attendu apparaît. L’opposition entre Airflow « chronologique » et Dagster « événementiel » est donc aujourd’hui moins tranchée.
Dagster pousse néanmoins plus loin cette logique avec une automatisation déclarative directement appliquée aux actifs. Les sensors peuvent réagir à des événements externes et les Automation Conditions permettent de décider quand on doit être matérialiser un actif en fonction de son état, de ses dépendances ou de sa fraîcheur. Cette API moderne remplace progressivement les anciennes AutoMaterializePolicy.
L’arrivée de nouveaux fichiers, l’évolution d’un actif amont ou le dépassement d’une contrainte de fraîcheur peuvent ainsi déclencher une mise à jour lorsque les règles correspondantes ont été définies. Cette logique réduit la dépendance aux seuls calendriers et permet d’adapter davantage l’orchestration au rythme réel des données, sans supprimer pour autant les schedules classiques.
Une meilleure observabilité et une lineage intégrée
La traçabilité des données cartographie le parcours de l’information, de sa source aux tables et aux usages en aval. Airflow peut aujourd’hui produire ce lineage grâce notamment à son provider OpenLineage officiel et à des intégrations dédiées. Cette approche reste toutefois davantage ajoutée autour du modèle de DAGs et de tâches, alors que Dagster intègre le graphe des actifs et leurs dépendances directement dans son modèle central.
À l’inverse, Dagster génère largement cette traçabilité grâce à son paradigme centré sur les actifs de données. L’orchestrateur intègre l’observabilité et le suivi des flux directement au cœur de son interface utilisateur. Le développement local s’en trouve aussi fortement simplifié via des commandes légères en ligne de commande. Cette approche native transforme ainsi la cartographie des pipelines en un standard au sein de son écosystème.
En matière de contrôle qualité, Dagster propose des Asset Checks directement associés aux actifs. Ils peuvent vérifier la fraîcheur, le schéma, le nombre de lignes ou d’autres règles métier et exposer le résultat dans l’interface. Un check en échec ne bloque pas nécessairement le pipeline : il peut simplement signaler une anomalie ou, si la politique choisie l’exige, empêcher l’exécution d’éléments en aval. Airflow s’appuie plus souvent sur des tâches, opérateurs ou outils de qualité dédiés pour produire le même type de contrôle.
Une expérience de développement plus moderne
Dagster applique les principes fondamentaux du génie logiciel à la gestion des pipelines. La logique de transformation métier s’y isole nettement des contraintes d’infrastructure. Les équipes peuvent ainsi tester leurs composants et simuler des dépendances externes avec pytest. Cette démarche garantit un code plus solide, lisible et facile à maintenir.
L’environnement local de Dagster accélère aussi la boucle de rétroaction des développeurs. La commande dg check defs valide les définitions, tandis que dg dev lance rapidement l’environnement de développement et l’interface. Grâce aux Code Locations, plusieurs projets peuvent utiliser des environnements Python distincts et communiquer avec le processus Dagster via RPC/gRPC. Cette séparation réduit les conflits de dépendances entre pipelines.
Enfin, la plateforme s’intègre nativement avec dbt en exploitant directement son fichier manifest.json. Chaque modèle SQL ou test devient alors un actif de données clairement identifié. Une interface unique peut rassembler l’ingestion Python, les transformations SQL et certains modèles d’IA. Toute la chaîne analytique bénéficie ainsi d’une supervision fluide et largement unifiée.
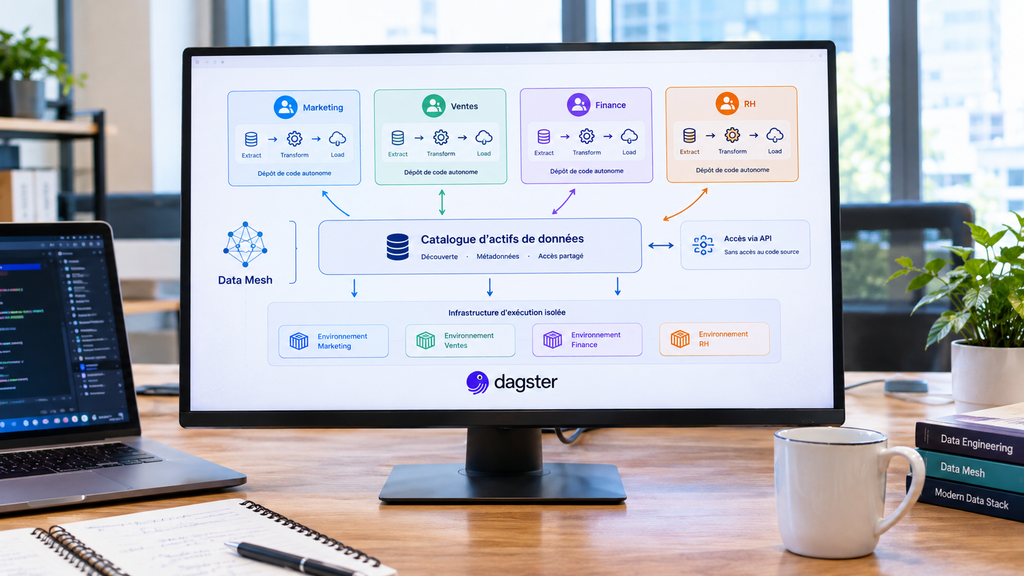
Une architecture adaptée à l’organisation en Data Mesh
Dans les grandes organisations, une plateforme d’orchestration trop centralisée peut devenir un goulot d’étranglement, quel que soit l’outil qu’on utilise. Airflow peut être organisé pour plusieurs équipes, mais cela demande une architecture de déploiement, des permissions et des conventions adaptées. Dagster met particulièrement en avant une organisation par Code Locations et domaines de données, ce qui peut faciliter une approche plus décentralisée.
Dagster facilite cette décentralisation en permettant à différents domaines de maintenir leurs propres dépôts et environnements de code tout en publiant leurs actifs dans une même vue logique. Cette organisation peut bien s’accorder avec les principes du Data Mesh. Pour cela, il faut que la gouvernance, les contrats de données et les responsabilités entre équipes soient eux aussi clairement définis.
La plateforme peut également fournir une vue partagée des actifs issus de plusieurs équipes et Code Locations. Les dépendances entre domaines deviennent visibles sans imposer que tous les projets partagent le même environnement Python ou le même dépôt. Cette séparation technique ne remplace toutefois pas les contrats de données, les contrôles d’accès et les règles de gouvernance nécessaires à une véritable organisation Data Mesh.
Pourquoi Dagster est particulièrement adapté aux nouveaux projets
Lors de la création d’une nouvelle plateforme, les équipes partent d’une feuille blanche sans contrainte historique. Ce cadre favorise l’adoption immédiate d’une modélisation axée sur les actifs de données. Choisir Dagster dès le départ évite souvent de supporter la dette technique liée à des DAGs hérités. Les ingénieurs déploient ainsi une architecture moderne et adaptée aux exigences stratégiques actuelles.
Dagster constitue un candidat particulièrement naturel pour les organisations exploitant intensivement dbt. Son intégration peut importer le manifest dbt afin de représenter les modèles, sources et tests sous forme d’actifs et de dépendances visibles dans le même graphe. Airflow dispose lui aussi d’intégrations dbt, mais Dagster tire ici parti de son modèle asset-centric pour unifier plus directement transformation, lineage, qualité et orchestration.
La plateforme orchestre aussi conjointement les pipelines analytiques et les modèles d’IA. Cette vision unifiée facilite le déploiement comme la maintenance des projets de Machine Learning. Les ingénieurs pilotent l’essentiel de la chaîne des données au sein d’une interface centralisée. L’organisation consolide enfin son infrastructure pour répondre aux besoins futurs de croissance.

Airflow reste-t-il un choix pertinent ?
Remplacer totalement Apache Airflow n’est ni faisable ni pertinent pour l’ensemble du marché. Les entreprises possédant des milliers de DAGs stables ont rarement un intérêt financier à tout réécrire. Le coût d’une migration lourde dépasse souvent les bénéfices opérationnels escomptés. De plus, leurs équipes techniques maîtrisent déjà bien cet outil d’orchestration mature.
Airflow conserve une efficacité redoutable pour les tâches d’infrastructure impératives. Il excelle dans la gestion de clusters, les sauvegardes et l’automatisation de scripts. Par ailleurs, la richesse de son écosystème de connecteurs demeure largement inégalée. Sa vaste communauté maintient une multitude de providers couvrant la plupart des services.
Le choix dépend avant tout du contexte. Airflow reste une référence extrêmement mature, avec un immense écosystème, et ses versions 3.x réduisent une partie de l’écart grâce aux Assets et à l’event-driven scheduling. Dagster conserve néanmoins un avantage conceptuel pour les équipes qui veulent placer les actifs de données, leur qualité, leur fraîcheur et leur lineage au centre de l’orchestration. Il ne remplace donc pas Airflow partout, mais devient une alternative de plus en plus crédible pour les nouveaux projets data-centric.
La migration progressive avec Airlift
Pour éviter les risques d’une migration globale, Dagster propose Airlift afin d’organiser une transition progressive depuis Airflow. Les équipes peuvent commencer par représenter et observer des workloads Airflow depuis Dagster, puis déplacer seulement certains traitements lorsque le bénéfice est clair. Cette approche réduit le besoin d’une réécriture immédiate de l’ensemble des DAGs et limite le risque d’un basculement en une seule étape.
Une première étape peut consister à représenter dans Dagster les traitements encore exécutés par Airflow afin de disposer d’une vision unifiée des actifs et de leurs dépendances. Les équipes peuvent ensuite sélectionner les workloads dont la migration apporte le plus de valeur et les réimplémenter progressivement avec les primitives natives de Dagster, notamment les Software-Defined Assets, sans imposer une conversion uniforme de tous les DAGs.
La dernière étape consiste à réduire progressivement la dépendance à Airflow lorsque les workloads concernés ont réellement été migrés et stabilisés. Cette démarche ne garantit ni une migration gratuite ni l’absence totale de risque. Elle permet cependant d’étaler l’effort, de conserver les DAGs stables qui n’ont pas intérêt à être réécrits et de moderniser l’architecture au rythme de l’organisation.
- Partager l'article :


